Software I: Modelo de procesamiento de datos

Modelo de procesamiento de datos NDVI.

Berlin, Germany15 de diciembre de 2025 – 31 de octubre de 2026

Primera recogida de datos

La campaña de 2025: cómo se prepararon los datos de entrada, qué modelo se eligió y cómo se entrenó.

Análisis de la infraestructura de datos de entrada

Resumen

Este informe presenta un marco metodológico para procesar datos multiespectrales de dron de parcelas de trigo y estimar las necesidades de nitrógeno y agua mediante aprendizaje automático y una evaluación basada en LLM.

Preparación y definición de los datos

El conjunto de datos combina estadísticas XML derivadas de imágenes multiespectrales de dron con variables de nitrógeno y riego por parcela.

  • Clases de nitrógeno: 0 g/m² (bajo), 10 g/m² (medio), 20 g/m² (ideal).
  • Clases de riego: 0 % (bajo), 50 % (medio), 100 % (ideal).
  • Primera observación de correlación: el nitrógeno guarda una relación más fuerte con el NDVI que el riego.

Metodología y procesamiento de datos

  • Transformar los datos del formato ancho (columnas de fechas) al formato largo (una fila por momento de medición).
  • Añadir los DDS (días desde la siembra) para modelizar el efecto de la edad biológica en la dinámica del NDVI.
  • Normalizar las variables con StandardScaler; codificar los valores categóricos con LabelEncoder.
  • Añadir el rango de heterogeneidad (máx.–mín.) como variable para captar la variabilidad dentro de la parcela, relevante para el estrés hídrico.
Selección del modelo

Aprendizaje automático frente a grandes modelos de lenguaje

  • ML: bajo coste de cómputo, fiabilidad determinista, requiere conocimiento del dominio para la ingeniería de variables (DDS, escalado).
  • LLM: alto coste de cómputo y de API, puede captar relaciones lógicas pero conlleva riesgo de alucinaciones.
  • Configuración few-shot: proporcionar 215 muestras de entrenamiento reales y pedir 55 predicciones de prueba.

Resultados del análisis

Predicción del nitrógeno

Aspectos destacados

Gemini 3 (LLM) alcanzó un 72,73 % de precisión; Naive Bayes encabezó los modelos de ML con un 65,50 %.

Predicción del estrés hídrico (riego)

Aspectos destacados

Gemini 3 y DeepSeek-V3 alcanzaron un 54,55 %; el árbol de decisión encabezó los modelos de ML con un 49,10 %.

Comparación completa

La tabla de resultados incluida contiene el conjunto completo de modelos evaluados y sus precisiones.

Evaluación general y hoja de ruta

  • Aprendizaje clave: el procesamiento guiado por expertos (especialmente los DDS) es fundamental.
  • Decisión: adoptar Naive Bayes para el nitrógeno (rentable y estable entre los modelos de ML).
  • Decisión: adoptar el árbol de decisión para el estrés hídrico, para captar ramificaciones no lineales.

Entrenamiento del modelo

Resumen

Este informe describe la metodología de entrenamiento, los criterios de selección y los procesos operativos de los modelos de clasificación entrenados con datos agrícolas procesados (DDS, estadísticas espectrales, identificadores de parcela).

Estrategia y metodología de entrenamiento de los modelos

  • División por grupos (GroupShuffleSplit): agrupar por identificador de parcela para evitar la memorización cuando la misma parcela aparece en varias fechas.
  • La selección de algoritmos prima la idoneidad para datos limitados y la lógica agronómica sobre la mera precisión matemática.
  • Normalización y etiquetado: normalizar las entradas con StandardScaler; codificar los objetivos mediante Label Encoding.

Idea clave

Evaluar la generalización en parcelas que el modelo nunca ha visto, impidiendo la filtración de identificadores de parcela entre entrenamiento y prueba.

Modelos seleccionados y justificación

Predicción del nitrógeno

Naive Bayes gaussiano — 65,5 % de precisión

Seleccionado por su estabilidad con pocas observaciones y por la fuerte correlación entre el NDVI y los índices espectrales y el nitrógeno, lo que reduce el riesgo de sobreajuste.

Predicción del riego

Árbol de decisión — 49,1 % de precisión

Seleccionado para captar los efectos no lineales y dependientes de umbrales del riego en la morfología de las plantas.

Gestión de los modelos

  • Persistencia de objetos: serializar los modelos entrenados, los escaladores y los codificadores de etiquetas en .pkl para reutilizarlos sin reentrenar.
  • Flujo de inferencia: aceptar los datos XML sin procesar y las fechas de vuelo; aplicar los mismos pasos de escalado y codificación usados en el entrenamiento.

Evaluación general y limitaciones

El principal cuello de botella es la escasez de volumen del conjunto de datos; la precisión en riego está limitada por una diversidad insuficiente para generalizar.

Conclusión

La infraestructura está validada lógicamente; se espera una mayor precisión mediante el reentrenamiento a medida que aumente el volumen de datos, sin cambios estructurales en el código.

Segunda recogida de datos

Actualización de los modelos y análisis de la precisión tras la segunda recogida de datos

La segunda recogida de datos

La segunda recogida de datos abarca la campaña de trigo 2026 en el mismo campo de ensayo de 54 parcelas de Adana, gestionado por la Universidad de Çukurova. El diseño del ensayo es idéntico al de la primera campaña: tres niveles de nitrógeno (0, 10 y 20 g/m²) y tres niveles de riego (0 %, 50 % y 100 %), con cada una de las nueve combinaciones aplicada a seis parcelas, en dos bloques de siembra (siembra temprana el 26 de diciembre de 2025 y siembra tardía el 9 de marzo de 2026).

El campo se sobrevoló siete veces entre el 24 de febrero y el 30 de junio de 2026 con un dron multiespectral DJI Mavic 3M a 50 m de altura. Las imágenes se convirtieron en mapas NDVI y se entregaron como estadísticas zonales por parcela, una tabla por vuelo.

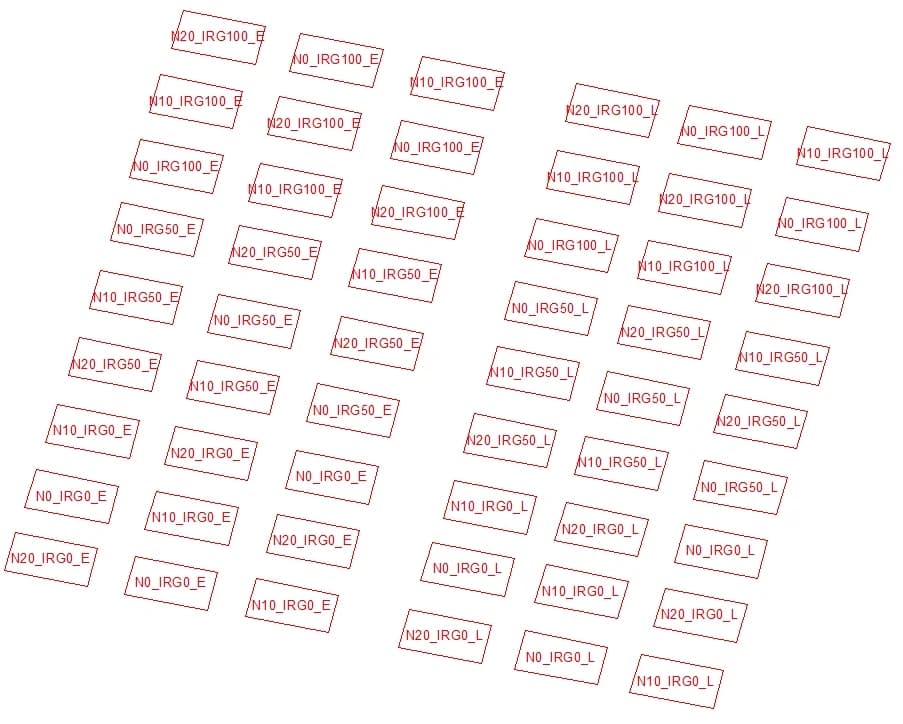
Mapa de las 54 parcelas, cada una etiquetada con su tratamiento, por ejemplo N20_IRG100_E: 20 g/m² de nitrógeno, 100 % de riego, siembra temprana.
El diseño del ensayo procedente del archivo de datos de Çukurova: cada parcela está etiquetada con su nivel de nitrógeno (N0, N10, N20), su nivel de riego (IRG0, IRG50, IRG100) y su bloque (E temprano, L tardío). El riego se aplica en franjas a lo largo de cada bloque; el nitrógeno varía dentro de cada franja.
  • Campaña 2025: 5 vuelos (15 de abril – 16 de junio de 2025), 270 mediciones de parcelas.
  • Campaña 2026: 7 vuelos (24 de febrero – 30 de junio de 2026), 324 mediciones de parcelas.
  • Total: 594 mediciones de parcelas de 54 parcelas en dos campañas.

Cómo trabajamos

Las dos campañas se prepararon como un único conjunto de datos coherente, se seleccionó el mejor modelo para el nitrógeno y para el riego, y se analizó el resultado. Todos los pasos son cuadernos de Python reproducibles; cada cifra se calcula a partir de los datos.

  • Mismo método de medición para ambas campañas: solo se usaron las estadísticas disponibles en los dos años (media, máximo, mínimo, desviación típica y rango del NDVI por parcela, además de los días desde la siembra).
  • Comprobación de etiquetas: 10 parcelas del bloque tardío de la tabla de etiquetas de 2026 contradecían su código de parcela; se utilizó el código de parcela, ya que coincide con el diseño de 2025 y con el mapa del campo.
  • Mediciones no válidas eliminadas: dos vuelos de 2026 se realizaron antes de sembrar el bloque tardío, por lo que esas 54 mediciones mostraban suelo desnudo, no trigo.
  • Mismo uso que en el campo: el modelo predice los niveles de una parcela a partir de un solo vuelo y de los días desde la siembra, exactamente como lo usa el software.
  • Prueba justa: todas las mediciones de una parcela permanecen juntas en el entrenamiento o en la prueba; 5 grupos de parcelas, repetidos 3 veces, dan 15 rondas de prueba. Adivinar al azar obtiene un 33 %.

Modelos probados y seleccionados

Se probaron doce modelos de clasificación que cubren todas las familias habituales: regresión logística, Ridge, k vecinos más cercanos, Naive Bayes, máquina de vectores de soporte, árbol de decisión, bosque aleatorio, Extra Trees, AdaBoost, Gradient Boosting, XGBoost y CatBoost. Todos quedaron en una franja estrecha: 42–51 % en nitrógeno y 27–36 % en riego. La diferencia entre el mejor y el peor (unos 9 puntos) es la misma que la variación normal entre rondas de prueba (unos ±6 puntos), por lo que la elección del algoritmo influye poco.

Nitrógeno: XGBoost

51 % de precisión · azar 33 % · p = 0,01

Identifica con fiabilidad las parcelas que no recibieron fertilizante, pero a menudo confunde los niveles de 10 y 20 g/m². Una prueba de permutación confirma que la señal de nitrógeno es real.

Riego: Extra Trees

36 % de precisión · p = 0,14

La puntuación más alta entre los candidatos, pero estadísticamente indistinguible del azar. Se incluye en el software para que esté completo; su resultado no debe usarse para decisiones de riego.

Por qué cambiaron los modelos respecto a la Recogida de datos 1

En la primera fase se eligieron Naive Bayes (nitrógeno) y un árbol de decisión (riego) a partir de una única división de prueba de 11 parcelas. Medido en 15 rondas, Naive Bayes alcanzó un 42 % en nitrógeno, de los más bajos de los 12 modelos. Los modelos de la primera fase también usaban la mediana del NDVI, que las tablas de 2026 no incluyen, por lo que en cualquier caso hacía falta una nueva selección.

Por qué no aumentó la precisión

El primer informe daba un 65,5 % en nitrógeno y un 49,1 % en riego, a partir de una única división de prueba. Repetir ese procedimiento en 200 divisiones aleatorias dio una media del 44 % en nitrógeno, y los modelos de la primera fase aplicados sin cambios a los datos de 2026 alcanzaron un 47 % y un 36 %. Las nuevas cifras no son un retroceso: son una medición más fiable del mismo límite, que está en lo que el NDVI puede mostrar en este ensayo.

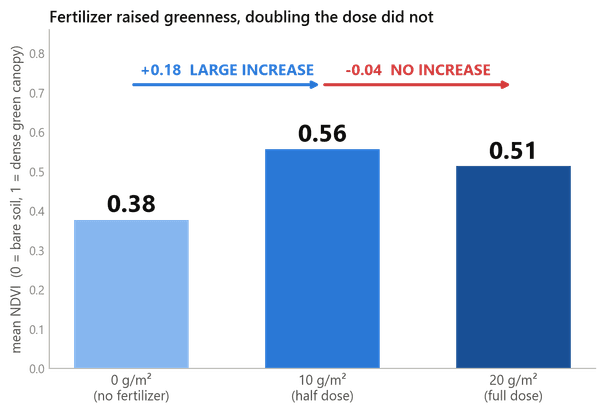
Gráfico de barras: NDVI medio de 0,38 con 0 g/m², 0,56 con 10 g/m² y 0,51 con 20 g/m² de nitrógeno.
Figura 1. NDVI medio por nivel de nitrógeno (las 594 mediciones, ambas campañas).

La media dosis elevó claramente el NDVI (de 0,38 a 0,56); la dosis completa no lo elevó más (0,51). Las parcelas no fertilizadas se pueden distinguir (80 % en una prueba de dos clases frente al 67 % de responder siempre «fertilizado»), pero la media dosis y la dosis completa no (49 %, como lanzar una moneda). El techo práctico para el nitrógeno ronda, por tanto, el 67 %, y el modelo seleccionado recorre aproximadamente la mitad de la distancia entre el azar y ese techo.

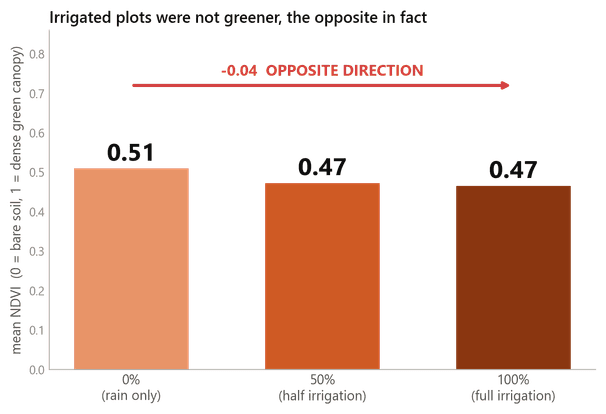
Gráfico de barras: el NDVI medio es casi el mismo con un 0 %, un 50 % y un 100 % de riego.
Figura 2. NDVI medio por nivel de riego (las 594 mediciones, ambas campañas).

Los tres niveles de riego tienen casi el mismo NDVI medio, y las parcelas sin riego estaban incluso algo más verdes (0,51) que las regadas por completo (0,47). Cada nivel de riego ocupa una franja continua del campo, por lo que el nivel de riego y la posición en el campo son la misma variable (ρ de Spearman = 0,94; para el nitrógeno, ρ = 0,01): ningún modelo puede distinguir el agua de la ubicación.

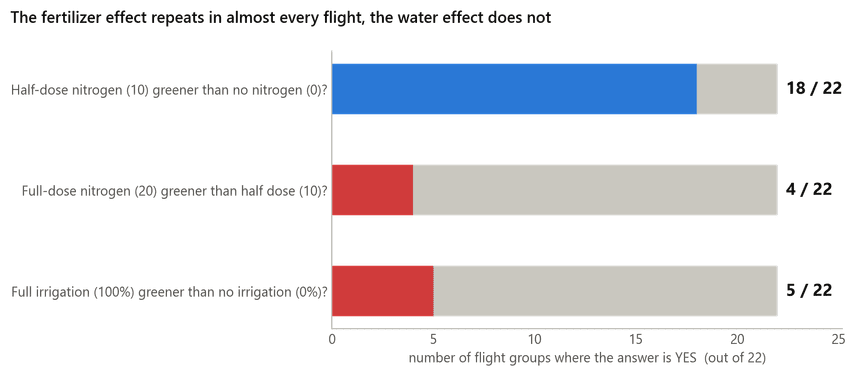
Gráfico: en cuántos de los 22 grupos de vuelos se cumple cada comparación de NDVI.
Figura 3. Número de grupos de vuelos en los que se cumple cada comparación (12 vuelos × 2 bloques de siembra = 22 grupos).

Comprobado vuelo a vuelo, la media dosis estaba más verde que la ausencia de fertilizante en 18 de 22 grupos, así que el efecto del nitrógeno es constante. La dosis completa estaba más verde que la media dosis solo en 4 de 22, y las parcelas regadas por completo estaban más verdes que las no regadas solo en 5 de 22.

Meteorología: ¿había llovido ya lo suficiente?

Se comparó la meteorología diaria del campo (reanálisis ERA5, archivo de Open-Meteo) con la demanda de agua del cultivo (evapotranspiración de referencia, ET₀). No se disponía de las fechas ni de las cantidades de riego, por lo que se utilizan solo datos meteorológicos.

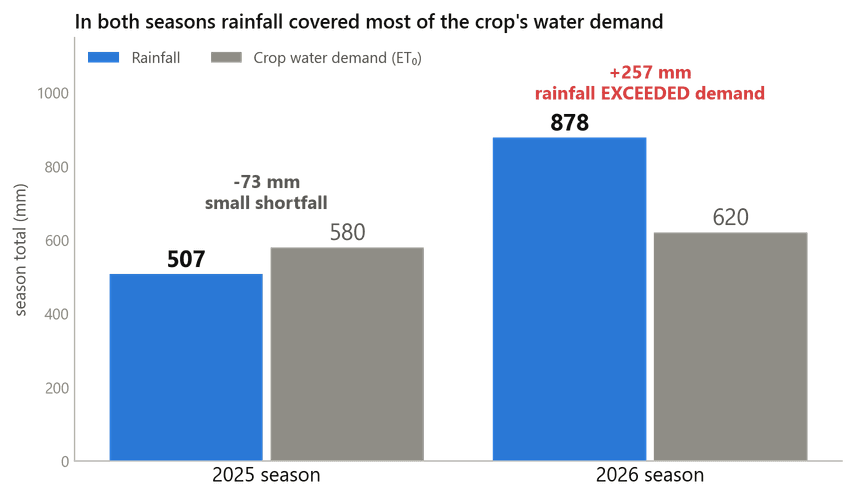
Gráfico de barras: lluvia de 2025, 507 mm frente a una demanda de 580 mm; lluvia de 2026, 878 mm frente a una demanda de 620 mm.
Figura 4. Lluvia total y demanda de agua del cultivo (ET₀) desde la siembra temprana hasta el último vuelo de cada campaña.
  • 2025: 507 mm de lluvia frente a una demanda de 580 mm; la lluvia cubrió alrededor del 87 % de la demanda.
  • 2026: 878 mm de lluvia frente a 620 mm; la lluvia superó la demanda en 257 mm, por lo que incluso las parcelas nunca regadas recibieron más agua de la necesaria.
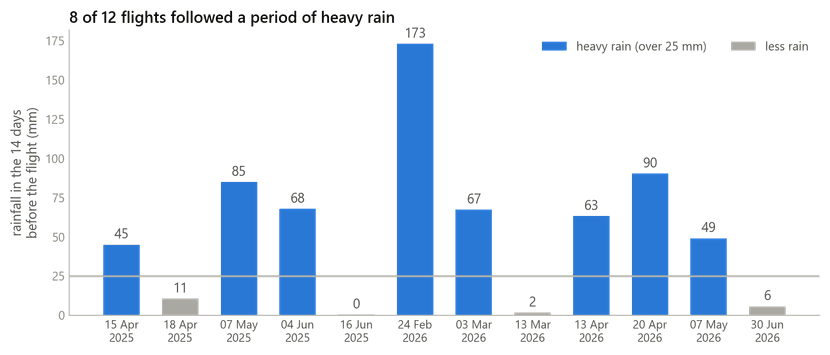
Gráfico: lluvia en los 14 días anteriores a cada uno de los 12 vuelos de dron.
Figura 5. Lluvia en los 14 días anteriores a cada vuelo de dron.

8 de los 12 vuelos se realizaron tras más de 25 mm de lluvia en las dos semanas anteriores (55 mm de media), por lo que la mayoría de las mediciones se tomaron cuando todo el campo se había mojado recientemente, fuera cual fuera su nivel de riego.

Evaluación general

  • Nitrógeno: el NDVI del dron contiene una señal de nitrógeno real y repetible. El modelo detecta con fiabilidad las parcelas no fertilizadas, pero no puede separar la media dosis de la dosis completa. Su 51 % está claramente por encima del azar (33 %) y aproximadamente a medio camino del techo práctico (en torno al 67 %).
  • Riego: los datos no contienen ninguna señal de riego aprovechable. Los niveles de riego coinciden con la posición en el campo, y la lluvia cubrió la mayor parte de la demanda de agua en ambas campañas. Es una limitación del diseño del ensayo y de la meteorología, no del modelo.
  • Es poco probable que ayuden más datos del mismo tipo u otro algoritmo: los 12 modelos rinden de forma parecida, y ampliar el conjunto de entrenamiento de 24 a 43 parcelas solo mejoró la precisión en nitrógeno en 2,7 puntos.

Posibles mejoras

Expresar el NDVI de cada parcela en relación con las demás parcelas del mismo vuelo elevó la precisión en nitrógeno del 49 % al 56 % en las pruebas; no forma parte del modelo entregado. Para futuros ensayos: repartir los niveles de riego por el campo en lugar de en franjas, registrar las fechas y cantidades de riego, medir la humedad del suelo y probar bandas espectrales más allá del NDVI, como el red edge.

Informes

  • Data Processing Model Training ReportPDF
  • Input Data Infrastructure and Data Processing Model Selection ReportPDF
  • Data Collection 2 Software Integration ReportPDF