Logiciel I : Modèle de traitement des données

Modèle de traitement des données NDVI.

Berlin, Germany15 décembre 2025 – 31 octobre 2026

Première collecte de données

La saison 2025 : comment les données d'entrée ont été préparées, quel modèle a été choisi et comment il a été entraîné.

Analyse de l'infrastructure des données d'entrée

Vue d'ensemble

Ce rapport présente un cadre méthodologique pour traiter les données multispectrales de drone de parcelles de blé et estimer les besoins en azote et en eau à l'aide de l'apprentissage automatique et d'une évaluation par LLM.

Préparation et définition des données

Le jeu de données combine des statistiques XML issues d'images multispectrales de drone avec des variables d'azote et d'irrigation par parcelle.

  • Classes d'azote : 0 g/m² (faible), 10 g/m² (moyen), 20 g/m² (idéal).
  • Classes d'irrigation : 0 % (faible), 50 % (moyen), 100 % (idéal).
  • Premier constat de corrélation : l'azote est plus fortement lié au NDVI que l'irrigation.

Méthodologie et traitement des données

  • Transformer les données du format large (colonnes de dates) au format long (une ligne par moment de mesure).
  • Ajouter les JAS (jours après semis) pour modéliser l'effet de l'âge biologique sur la dynamique du NDVI.
  • Normaliser les variables avec StandardScaler ; encoder les valeurs catégorielles avec LabelEncoder.
  • Ajouter l'étendue d'hétérogénéité (max–min) comme variable pour saisir la variabilité au sein de la parcelle, utile pour le stress hydrique.
Sélection du modèle

Apprentissage automatique ou grands modèles de langage

  • ML : faible coût de calcul, fiabilité déterministe, nécessite une expertise métier pour l'ingénierie des variables (JAS, mise à l'échelle).
  • LLM : coût de calcul et d'API élevé, peut saisir des relations logiques mais comporte un risque d'hallucination.
  • Configuration few-shot : fournir 215 échantillons d'entraînement réels et demander 55 prédictions de test.

Résultats de l'analyse

Prédiction de l'azote

Points clés

Gemini 3 (LLM) a atteint 72,73 % de précision ; Naive Bayes a mené les modèles ML avec 65,50 %.

Prédiction du stress hydrique (irrigation)

Points clés

Gemini 3 et DeepSeek-V3 ont atteint 54,55 % ; l'arbre de décision a mené les modèles ML avec 49,10 %.

Comparaison complète

Le tableau de résultats intégré présente l'ensemble des modèles évalués et leurs précisions.

Évaluation générale et feuille de route

  • Enseignement clé : un traitement guidé par l'expertise (en particulier les JAS) est essentiel.
  • Décision : adopter Naive Bayes pour l'azote (économique et stable parmi les modèles ML).
  • Décision : adopter l'arbre de décision pour le stress hydrique afin de saisir les ramifications non linéaires.

Entraînement du modèle

Vue d'ensemble

Ce rapport décrit la méthode d'entraînement, les critères de sélection et les processus opérationnels des modèles de classification entraînés sur des données agricoles traitées (JAS, statistiques spectrales, identifiants de parcelle).

Stratégie et méthodologie d'entraînement des modèles

  • Découpage par groupes (GroupShuffleSplit) : regrouper par identifiant de parcelle pour éviter la mémorisation lorsque la même parcelle apparaît à plusieurs dates.
  • Le choix des algorithmes privilégie l'adéquation à des données limitées et à la logique agronomique plutôt que la seule précision mathématique.
  • Normalisation et étiquetage : normaliser les entrées avec StandardScaler ; encoder les cibles par Label Encoding.

Idée clé

Évaluer la généralisation sur des parcelles que le modèle n'a jamais vues, en empêchant toute fuite d'identifiant de parcelle entre entraînement et test.

Modèles retenus et justification

Prédiction de l'azote

Naive Bayes gaussien — 65,5 % de précision

Retenu pour sa stabilité avec peu d'observations et pour la forte corrélation entre le NDVI et les indices spectraux d'une part et l'azote d'autre part, ce qui réduit le risque de surapprentissage.

Prédiction de l'irrigation

Arbre de décision — 49,1 % de précision

Retenu pour saisir les effets non linéaires, liés à des seuils, de l'irrigation sur la morphologie des plantes.

Gestion des modèles

  • Persistance des objets : sérialiser les modèles entraînés, les scalers et les encodeurs d'étiquettes en .pkl pour les réutiliser sans réentraînement.
  • Chaîne d'inférence : accepter les données XML brutes et les dates de vol ; appliquer les mêmes étapes de mise à l'échelle et d'encodage qu'à l'entraînement.

Évaluation générale et contraintes

Le principal goulot d'étranglement est le faible volume du jeu de données ; la précision pour l'irrigation est limitée par une diversité insuffisante pour généraliser.

Conclusion

L'infrastructure est logiquement validée ; une meilleure précision est attendue grâce au réentraînement à mesure que le volume de données augmente, sans modification structurelle du code.

Deuxième collecte de données

Mise à jour des modèles et analyse de la précision après la deuxième collecte de données

La deuxième collecte de données

La deuxième collecte de données porte sur la saison de blé 2026 dans le même champ d'essai de 54 parcelles à Adana, géré par l'Université de Çukurova. Le dispositif est identique à celui de la première saison : trois niveaux d'azote (0, 10 et 20 g/m²) et trois niveaux d'irrigation (0 %, 50 % et 100 %), chacune des neuf combinaisons appliquée à six parcelles, en deux blocs de semis (semis précoce le 26 décembre 2025, semis tardif le 9 mars 2026).

Le champ a été survolé sept fois entre le 24 février et le 30 juin 2026 avec un drone multispectral DJI Mavic 3M à 50 m d'altitude. Les images ont été transformées en cartes NDVI et livrées sous forme de statistiques zonales par parcelle, un tableau par vol.

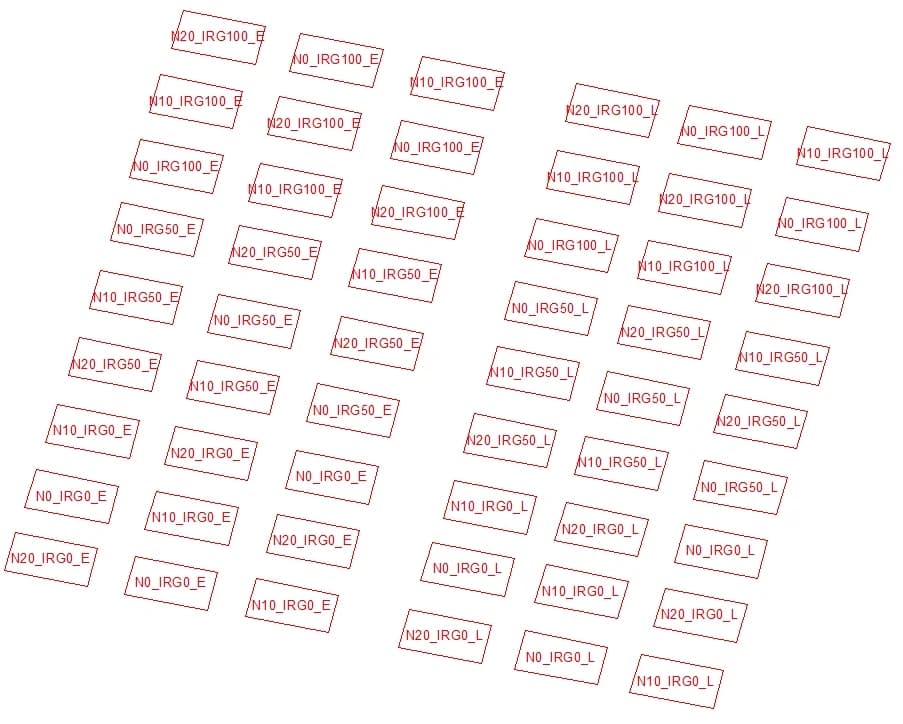
Carte des 54 parcelles, chacune étiquetée avec son traitement, par exemple N20_IRG100_E : 20 g/m² d'azote, 100 % d'irrigation, semis précoce.
Le plan de l'essai issu des archives de données de Çukurova : chaque parcelle est étiquetée avec son niveau d'azote (N0, N10, N20), son niveau d'irrigation (IRG0, IRG50, IRG100) et son bloc (E précoce, L tardif). L'irrigation est appliquée en bandes à travers chaque bloc ; l'azote varie au sein de chaque bande.
  • Saison 2025 : 5 vols (15 avril – 16 juin 2025), 270 mesures de parcelles.
  • Saison 2026 : 7 vols (24 février – 30 juin 2026), 324 mesures de parcelles.
  • Total : 594 mesures de parcelles sur 54 parcelles en deux saisons.

Notre méthode de travail

Les deux saisons ont été préparées comme un seul jeu de données cohérent, le meilleur modèle a été choisi pour l'azote et pour l'irrigation, et le résultat a été analysé. Toutes les étapes sont des notebooks Python reproductibles ; chaque chiffre est calculé à partir des données.

  • Même méthode de mesure pour les deux saisons : seules les statistiques disponibles les deux années ont été utilisées (moyenne, maximum, minimum, écart type et étendue du NDVI par parcelle, plus les jours après semis).
  • Vérification des étiquettes : 10 parcelles du bloc tardif dans le tableau d'étiquettes 2026 contredisaient leur code de parcelle ; c'est le code de parcelle qui a été retenu, car il correspond au plan de 2025 et à la carte du champ.
  • Mesures invalides supprimées : deux vols de 2026 ont eu lieu avant le semis du bloc tardif ; ces 54 mesures montraient donc du sol nu, et non du blé.
  • Même usage que sur le terrain : le modèle prédit les niveaux d'une parcelle à partir d'un seul vol et des jours après semis, exactement comme le logiciel l'utilise.
  • Test équitable : toutes les mesures d'une parcelle restent ensemble, à l'entraînement ou au test ; 5 groupes de parcelles, répétés 3 fois, donnent 15 cycles de test. Un choix au hasard obtient 33 %.

Modèles testés et retenus

Douze modèles de classification couvrant toutes les familles courantes ont été testés : régression logistique, Ridge, k plus proches voisins, Naive Bayes, machine à vecteurs de support, arbre de décision, forêt aléatoire, Extra Trees, AdaBoost, Gradient Boosting, XGBoost et CatBoost. Tous se situent dans une fourchette étroite : 42–51 % pour l'azote et 27–36 % pour l'irrigation. L'écart entre le meilleur et le moins bon (environ 9 points) équivaut à la variation normale entre cycles de test (environ ±6 points) : le choix de l'algorithme a donc peu d'effet.

Azote : XGBoost

51 % de précision · hasard 33 % · p = 0,01

Repère de façon fiable les parcelles qui n'ont pas reçu d'engrais, mais confond souvent les niveaux de 10 et 20 g/m². Un test de permutation confirme que le signal d'azote est réel.

Irrigation : Extra Trees

36 % de précision · p = 0,14

Le meilleur score parmi les candidats, mais statistiquement impossible à distinguer du hasard. Il figure dans le logiciel par souci d'exhaustivité ; son résultat ne doit pas être utilisé pour les décisions d'irrigation.

Pourquoi les modèles ont changé depuis la Collecte de données 1

La première phase avait retenu Naive Bayes (azote) et un arbre de décision (irrigation) à partir d'un seul découpage de test de 11 parcelles. Mesuré sur 15 cycles, Naive Bayes atteint 42 % pour l'azote, parmi les plus faibles des 12 modèles. Les modèles de la première phase utilisaient aussi la médiane du NDVI, absente des tableaux 2026 : une nouvelle sélection était donc nécessaire de toute façon.

Pourquoi la précision n'a pas augmenté

Le premier rapport indiquait 65,5 % pour l'azote et 49,1 % pour l'irrigation, à partir d'un seul découpage de test. En répétant cette procédure sur 200 découpages aléatoires, la moyenne est de 44 % pour l'azote, et les modèles de la première phase appliqués tels quels aux données 2026 atteignent 47 % et 36 %. Les nouveaux chiffres ne sont pas un recul : ils mesurent de façon plus fiable la même limite, qui tient à ce que le NDVI peut montrer dans cet essai.

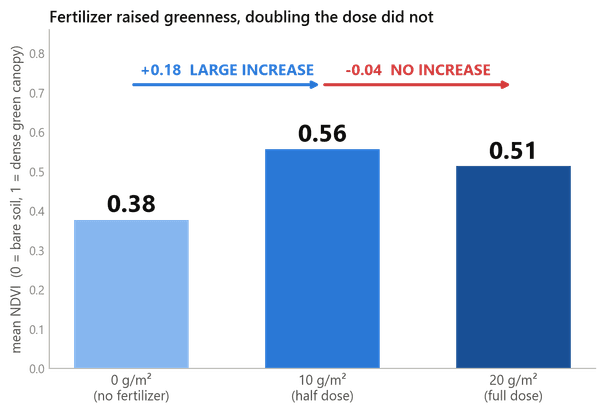
Diagramme en barres : NDVI moyen de 0,38 à 0 g/m², 0,56 à 10 g/m² et 0,51 à 20 g/m² d'azote.
Figure 1. NDVI moyen par niveau d'azote (les 594 mesures, deux saisons).

La demi-dose a nettement augmenté le NDVI (de 0,38 à 0,56) ; la dose complète ne l'a pas augmenté davantage (0,51). Les parcelles non fertilisées se distinguent (80 % dans un test à deux classes, contre 67 % en répondant toujours « fertilisé »), mais pas la demi-dose de la dose complète (49 %, pile ou face). Le plafond pratique pour l'azote est donc d'environ 67 %, et le modèle retenu parcourt environ la moitié de la distance entre le hasard et ce plafond.

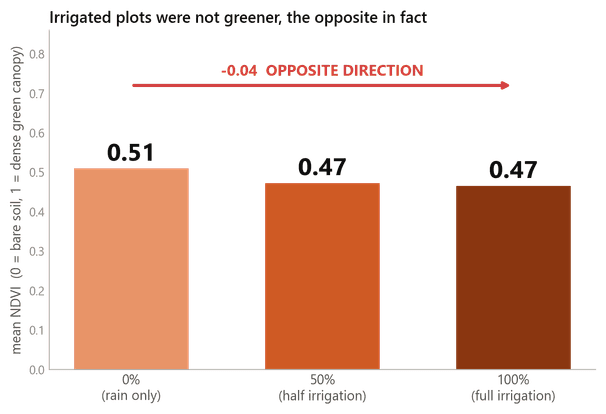
Diagramme en barres : le NDVI moyen est presque identique à 0 %, 50 % et 100 % d'irrigation.
Figure 2. NDVI moyen par niveau d'irrigation (les 594 mesures, deux saisons).

Les trois niveaux d'irrigation ont presque le même NDVI moyen, et les parcelles non irriguées étaient même légèrement plus vertes (0,51) que les parcelles entièrement irriguées (0,47). Chaque niveau d'irrigation occupe une bande continue du champ : le niveau d'irrigation et la position dans le champ sont donc la même variable (ρ de Spearman = 0,94 ; pour l'azote, ρ = 0,01) et aucun modèle ne peut distinguer l'eau de l'emplacement.

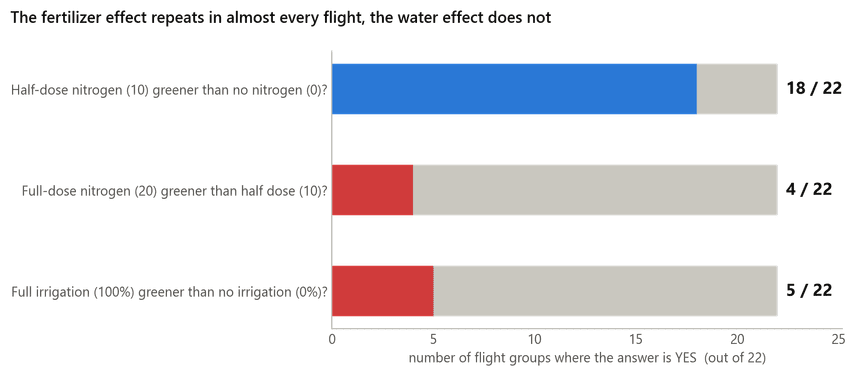
Graphique : dans combien des 22 groupes de vols chaque comparaison de NDVI se vérifie.
Figure 3. Nombre de groupes de vols dans lesquels chaque comparaison se vérifie (12 vols × 2 blocs de semis = 22 groupes).

Vérifiée vol par vol, la demi-dose était plus verte que l'absence d'engrais dans 18 groupes sur 22 : l'effet de l'azote est donc constant. La dose complète n'était plus verte que la demi-dose que dans 4 groupes sur 22, et les parcelles entièrement irriguées n'étaient plus vertes que les parcelles non irriguées que dans 5 groupes sur 22.

Météo : avait-il déjà assez plu ?

La météo quotidienne du champ (réanalyse ERA5, archives Open-Meteo) a été comparée aux besoins en eau de la culture (évapotranspiration de référence, ET₀). Les dates et volumes d'irrigation n'étaient pas disponibles : cette analyse repose donc uniquement sur les données météo.

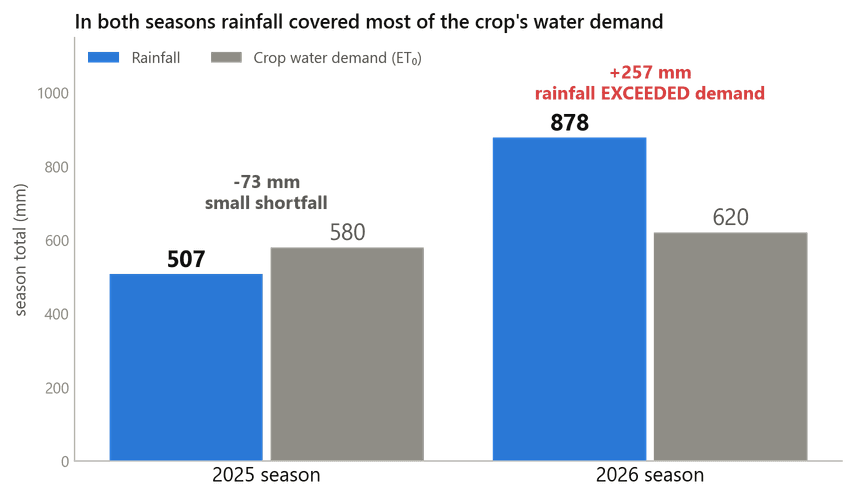
Diagramme en barres : pluviométrie 2025 de 507 mm pour des besoins de 580 mm ; pluviométrie 2026 de 878 mm pour des besoins de 620 mm.
Figure 4. Pluviométrie totale et besoins en eau de la culture (ET₀) du semis précoce au dernier vol de chaque saison.
  • 2025 : 507 mm de pluie pour des besoins de 580 mm ; la pluie a couvert environ 87 % des besoins.
  • 2026 : 878 mm de pluie pour 620 mm de besoins ; la pluie a dépassé les besoins de 257 mm, si bien que même les parcelles jamais irriguées ont reçu plus d'eau que nécessaire.
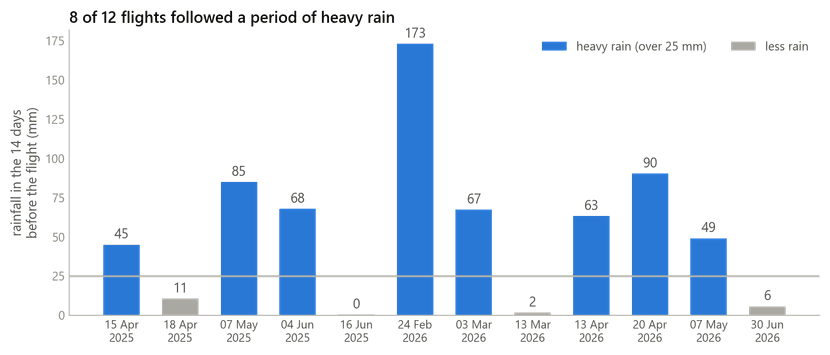
Graphique : pluviométrie des 14 jours précédant chacun des 12 vols de drone.
Figure 5. Pluviométrie des 14 jours précédant chaque vol de drone.

8 des 12 vols ont suivi plus de 25 mm de pluie au cours des deux semaines précédentes (55 mm en moyenne) : la plupart des mesures ont donc été prises alors que tout le champ venait d'être mouillé, quel que soit son niveau d'irrigation.

Évaluation générale

  • Azote : le NDVI du drone porte un signal d'azote réel et reproductible. Le modèle détecte de façon fiable les parcelles non fertilisées, mais ne sépare pas la demi-dose de la dose complète. Ses 51 % sont nettement au-dessus du hasard (33 %) et à mi-chemin environ du plafond pratique (environ 67 %).
  • Irrigation : les données ne contiennent aucun signal d'irrigation exploitable. Les niveaux d'irrigation coïncident avec la position dans le champ, et la pluie a couvert l'essentiel des besoins en eau lors des deux saisons. C'est une limite du dispositif de l'essai et de la météo, pas du modèle.
  • Davantage de données du même type ou un autre algorithme n'aideraient probablement pas : les 12 modèles se valent, et faire passer le jeu d'entraînement de 24 à 43 parcelles n'a amélioré la précision pour l'azote que de 2,7 points.

Améliorations possibles

Exprimer le NDVI de chaque parcelle par rapport aux autres parcelles du même vol a fait passer la précision pour l'azote de 49 % à 56 % lors des tests ; cela ne fait pas partie du modèle livré. Pour les futurs essais : répartir les niveaux d'irrigation dans le champ plutôt qu'en bandes, enregistrer les dates et volumes d'irrigation, mesurer l'humidité du sol et tester des bandes spectrales au-delà du NDVI, comme le red edge.

Rapports

  • Data Processing Model Training ReportPDF
  • Input Data Infrastructure and Data Processing Model Selection ReportPDF
  • Data Collection 2 Software Integration ReportPDF