Software I: Modello di elaborazione dei dati

Modello di elaborazione dei dati NDVI.

Berlin, Germany15 dicembre 2025 – 31 ottobre 2026

Prima raccolta dei dati

La stagione 2025: come sono stati preparati i dati di input, quale modello è stato scelto e come è stato addestrato.

Analisi dell'infrastruttura dei dati di input

Panoramica

Questo rapporto presenta un quadro metodologico per elaborare i dati multispettrali da drone di parcelle di frumento e stimare il fabbisogno di azoto e acqua mediante apprendimento automatico e una valutazione basata su LLM.

Preparazione e definizione dei dati

Il dataset combina statistiche XML derivate da immagini multispettrali da drone con variabili di azoto e irrigazione per parcella.

  • Classi di azoto: 0 g/m² (basso), 10 g/m² (medio), 20 g/m² (ideale).
  • Classi di irrigazione: 0% (basso), 50% (medio), 100% (ideale).
  • Prima osservazione sulla correlazione: l'azoto ha un legame più forte con l'NDVI rispetto all'irrigazione.

Metodologia ed elaborazione dei dati

  • Trasformare i dati dal formato largo (colonne di date) al formato lungo (una riga per momento di misurazione).
  • Aggiungere i GDS (giorni dalla semina) per modellare l'effetto dell'età biologica sulla dinamica dell'NDVI.
  • Normalizzare le variabili con StandardScaler; codificare i valori categoriali con LabelEncoder.
  • Aggiungere l'intervallo di eterogeneità (max–min) come variabile per cogliere la variabilità all'interno della parcella, rilevante per lo stress idrico.
Selezione del modello

Apprendimento automatico e modelli linguistici di grandi dimensioni a confronto

  • ML: basso costo di calcolo, affidabilità deterministica, richiede competenze di dominio per l'ingegneria delle variabili (GDS, scalatura).
  • LLM: costo di calcolo e di API elevato, può cogliere relazioni logiche ma comporta il rischio di allucinazioni.
  • Configurazione few-shot: fornire 215 campioni di addestramento reali e chiedere 55 previsioni di test.

Risultati dell'analisi

Previsione dell'azoto

Punti salienti

Gemini 3 (LLM) ha raggiunto un'accuratezza del 72,73%; Naive Bayes ha guidato i modelli di ML con il 65,50%.

Previsione dello stress idrico (irrigazione)

Punti salienti

Gemini 3 e DeepSeek-V3 hanno raggiunto il 54,55%; l'albero decisionale ha guidato i modelli di ML con il 49,10%.

Confronto completo

La tabella dei risultati inclusa contiene l'insieme completo dei modelli valutati e delle loro accuratezze.

Valutazione generale e percorso futuro

  • Insegnamento chiave: un'elaborazione guidata dalle competenze (soprattutto i GDS) è fondamentale.
  • Decisione: adottare Naive Bayes per l'azoto (economico e stabile tra i modelli di ML).
  • Decisione: adottare l'albero decisionale per lo stress idrico, per cogliere le ramificazioni non lineari.

Addestramento del modello

Panoramica

Questo rapporto descrive la metodologia di addestramento, i criteri di selezione e i processi operativi dei modelli di classificazione addestrati su dati agricoli elaborati (GDS, statistiche spettrali, ID delle parcelle).

Strategia e metodologia di addestramento dei modelli

  • Suddivisione per gruppi (GroupShuffleSplit): raggruppare per ID della parcella per evitare la memorizzazione quando la stessa parcella compare in più date.
  • La scelta degli algoritmi privilegia l'idoneità a dati limitati e la logica agronomica rispetto alla sola accuratezza matematica.
  • Standardizzazione ed etichettatura: normalizzare gli input con StandardScaler; codificare i target tramite Label Encoding.

Idea chiave

Valutare la generalizzazione su parcelle mai viste dal modello, impedendo la fuga degli ID delle parcelle tra addestramento e test.

Modelli scelti e motivazioni

Previsione dell'azoto

Naive Bayes gaussiano — accuratezza del 65,5%

Scelto per la sua stabilità con poche osservazioni e per la forte correlazione tra NDVI/indici spettrali e azoto, che riduce il rischio di overfitting.

Previsione dell'irrigazione

Albero decisionale — accuratezza del 49,1%

Scelto per cogliere gli effetti non lineari, legati a soglie, dell'irrigazione sulla morfologia delle piante.

Gestione dei modelli

  • Persistenza degli oggetti: serializzare modelli addestrati, scaler ed encoder delle etichette in .pkl per riutilizzarli senza riaddestramento.
  • Pipeline di inferenza: accettare i dati XML grezzi e le date di volo; applicare gli stessi passaggi di scalatura e codifica usati nell'addestramento.

Valutazione generale e vincoli

Il principale collo di bottiglia è la scarsità di volume del dataset; l'accuratezza per l'irrigazione è limitata da una diversità insufficiente per generalizzare.

Conclusione

L'infrastruttura è validata dal punto di vista logico; ci si attende una maggiore accuratezza con il riaddestramento man mano che il volume dei dati cresce, senza modifiche strutturali al codice.

Seconda raccolta dei dati

Aggiornamento dei modelli e analisi dell'accuratezza dopo la seconda raccolta dei dati

La seconda raccolta dei dati

La seconda raccolta dei dati riguarda la stagione del frumento 2026 nello stesso campo sperimentale di 54 parcelle ad Adana, gestito dall'Università di Çukurova. Il disegno della prova è identico a quello della prima stagione: tre livelli di azoto (0, 10 e 20 g/m²) e tre livelli di irrigazione (0%, 50% e 100%), ciascuna delle nove combinazioni applicata a sei parcelle, in due blocchi di semina (semina precoce il 26 dicembre 2025, semina tardiva il 9 marzo 2026).

Il campo è stato sorvolato sette volte tra il 24 febbraio e il 30 giugno 2026 con un drone multispettrale DJI Mavic 3M a 50 m di quota. Le immagini sono state trasformate in mappe NDVI e consegnate come statistiche zonali per parcella, una tabella per volo.

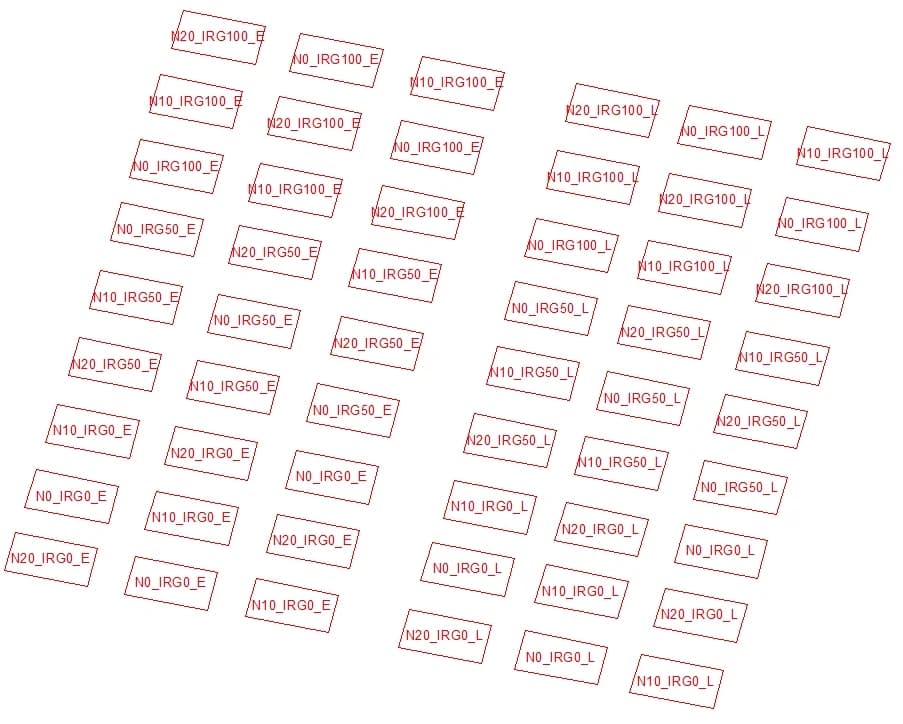
Mappa delle 54 parcelle, ciascuna etichettata con il suo trattamento, ad esempio N20_IRG100_E: 20 g/m² di azoto, 100% di irrigazione, semina precoce.
Il disegno della prova dall'archivio dati di Çukurova: ogni parcella è etichettata con il suo livello di azoto (N0, N10, N20), il livello di irrigazione (IRG0, IRG50, IRG100) e il blocco (E precoce, L tardivo). L'irrigazione è disposta a fasce attraverso ogni blocco; l'azoto varia all'interno di ciascuna fascia.
  • Stagione 2025: 5 voli (15 aprile – 16 giugno 2025), 270 misurazioni di parcelle.
  • Stagione 2026: 7 voli (24 febbraio – 30 giugno 2026), 324 misurazioni di parcelle.
  • Totale: 594 misurazioni di parcelle da 54 parcelle in due stagioni.

Come abbiamo lavorato

Le due stagioni sono state preparate come un unico dataset coerente, è stato scelto il modello migliore per l'azoto e per l'irrigazione, e il risultato è stato analizzato. Tutti i passaggi sono notebook Python riproducibili; ogni numero è calcolato dai dati.

  • Stesso metodo di misura per entrambe le stagioni: sono state usate solo le statistiche disponibili in tutti e due gli anni (media, massimo, minimo, deviazione standard e intervallo dell'NDVI per parcella, più i giorni dalla semina).
  • Verifica delle etichette: 10 parcelle del blocco tardivo nella tabella delle etichette 2026 contraddicevano il loro codice di parcella; è stato usato il codice di parcella, perché corrisponde al disegno del 2025 e alla mappa del campo.
  • Misurazioni non valide rimosse: due voli del 2026 sono avvenuti prima della semina del blocco tardivo, quindi quelle 54 misurazioni mostravano suolo nudo, non frumento.
  • Stesso uso che in campo: il modello prevede i livelli di una parcella a partire da un solo volo e dai giorni dalla semina, esattamente come lo usa il software.
  • Test equo: tutte le misurazioni di una parcella restano insieme, in addestramento o in test; 5 gruppi di parcelle, ripetuti 3 volte, danno 15 cicli di test. Indovinare a caso ottiene il 33%.

Modelli testati e scelti

Sono stati testati dodici modelli di classificazione che coprono tutte le famiglie più comuni: regressione logistica, Ridge, k vicini più prossimi, Naive Bayes, macchina a vettori di supporto, albero decisionale, foresta casuale, Extra Trees, AdaBoost, Gradient Boosting, XGBoost e CatBoost. Tutti si sono collocati in una fascia ristretta: 42–51% per l'azoto e 27–36% per l'irrigazione. Il divario tra il migliore e il peggiore (circa 9 punti) è pari alla normale variazione tra cicli di test (circa ±6 punti), quindi la scelta dell'algoritmo incide poco.

Azoto: XGBoost

Accuratezza 51% · caso 33% · p = 0,01

Individua in modo affidabile le parcelle che non hanno ricevuto concime, ma spesso confonde i livelli di 10 e 20 g/m². Un test di permutazione conferma che il segnale dell'azoto è reale.

Irrigazione: Extra Trees

Accuratezza 36% · p = 0,14

Il punteggio più alto tra i candidati, ma statisticamente indistinguibile dal caso. È presente nel software per completezza; il suo risultato non deve essere usato per le decisioni irrigue.

Perché i modelli sono cambiati rispetto alla Raccolta dati 1

La prima fase aveva scelto Naive Bayes (azoto) e un albero decisionale (irrigazione) sulla base di un'unica suddivisione di test di 11 parcelle. Misurato su 15 cicli, Naive Bayes ha raggiunto il 42% per l'azoto, tra i valori più bassi dei 12 modelli. I modelli della prima fase usavano anche la mediana dell'NDVI, che le tabelle 2026 non includono, quindi una nuova selezione era comunque necessaria.

Perché l'accuratezza non è aumentata

Il primo rapporto indicava il 65,5% per l'azoto e il 49,1% per l'irrigazione, da un'unica suddivisione di test. Ripetendo quella procedura su 200 suddivisioni casuali, la media è stata del 44% per l'azoto, e i modelli della prima fase applicati senza modifiche ai dati 2026 hanno raggiunto il 47% e il 36%. I nuovi valori non sono un peggioramento: sono una misura più affidabile dello stesso limite, che sta in ciò che l'NDVI può mostrare in questa prova.

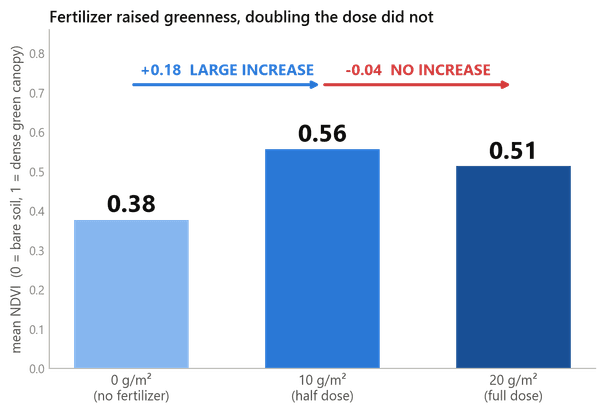
Grafico a barre: NDVI medio di 0,38 a 0 g/m², 0,56 a 10 g/m² e 0,51 a 20 g/m² di azoto.
Figura 1. NDVI medio per livello di azoto (tutte le 594 misurazioni, entrambe le stagioni).

La mezza dose ha aumentato nettamente l'NDVI (da 0,38 a 0,56); la dose piena non lo ha aumentato ulteriormente (0,51). Le parcelle non concimate si distinguono (80% in un test a due classi contro il 67% rispondendo sempre «concimato»), ma la mezza dose e la dose piena no (49%, come lanciare una moneta). Il limite pratico per l'azoto è quindi di circa il 67%, e il modello scelto copre circa metà della distanza tra il caso e quel limite.

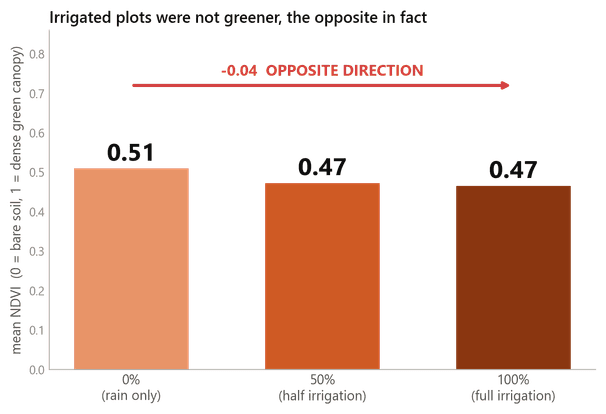
Grafico a barre: l'NDVI medio è quasi lo stesso con irrigazione allo 0%, al 50% e al 100%.
Figura 2. NDVI medio per livello di irrigazione (tutte le 594 misurazioni, entrambe le stagioni).

I tre livelli di irrigazione hanno quasi lo stesso NDVI medio, e le parcelle non irrigate erano persino leggermente più verdi (0,51) di quelle irrigate completamente (0,47). Ogni livello di irrigazione occupa una fascia continua del campo, quindi livello di irrigazione e posizione nel campo sono la stessa variabile (ρ di Spearman = 0,94; per l'azoto ρ = 0,01): nessun modello può distinguere l'acqua dalla posizione.

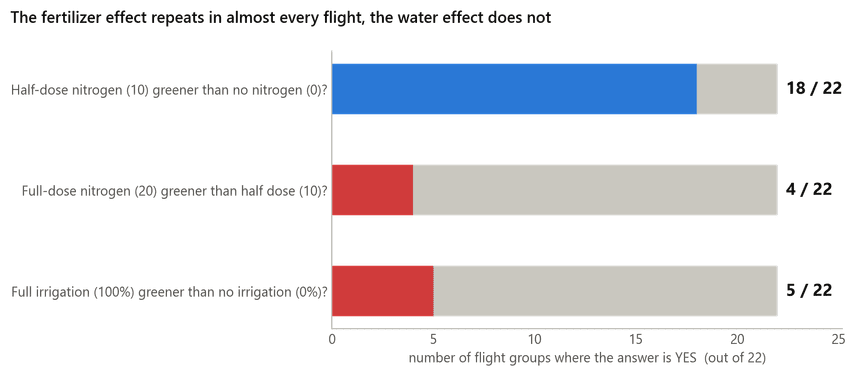
Grafico: in quanti dei 22 gruppi di voli vale ciascun confronto dell'NDVI.
Figura 3. Numero di gruppi di voli in cui vale ciascun confronto (12 voli × 2 blocchi di semina = 22 gruppi).

Verificata volo per volo, la mezza dose era più verde dell'assenza di concime in 18 gruppi su 22, quindi l'effetto dell'azoto è costante. La dose piena era più verde della mezza dose solo in 4 gruppi su 22, e le parcelle irrigate completamente erano più verdi di quelle non irrigate solo in 5 gruppi su 22.

Meteo: era già piovuto abbastanza?

Il meteo giornaliero del campo (rianalisi ERA5, archivio Open-Meteo) è stato confrontato con il fabbisogno idrico della coltura (evapotraspirazione di riferimento, ET₀). Le date e le quantità di irrigazione non erano disponibili, quindi si usano solo dati meteorologici.

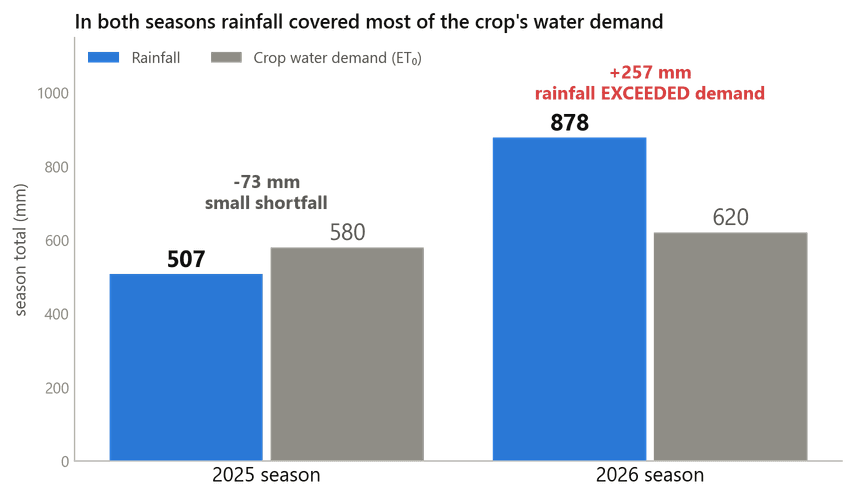
Grafico a barre: pioggia del 2025 di 507 mm a fronte di un fabbisogno di 580 mm; pioggia del 2026 di 878 mm a fronte di un fabbisogno di 620 mm.
Figura 4. Pioggia totale e fabbisogno idrico della coltura (ET₀) dalla semina precoce all'ultimo volo di ogni stagione.
  • 2025: 507 mm di pioggia a fronte di un fabbisogno di 580 mm; la pioggia ha coperto circa l'87% del fabbisogno.
  • 2026: 878 mm di pioggia a fronte di 620 mm; la pioggia ha superato il fabbisogno di 257 mm, quindi anche le parcelle mai irrigate hanno ricevuto più acqua del necessario.
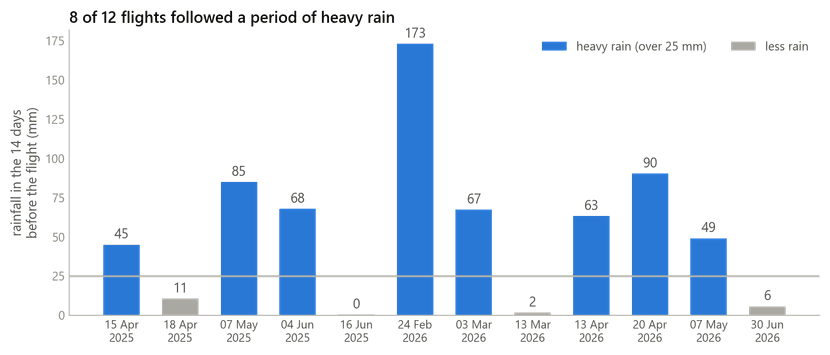
Grafico: pioggia nei 14 giorni precedenti ciascuno dei 12 voli con drone.
Figura 5. Pioggia nei 14 giorni precedenti ogni volo con drone.

8 dei 12 voli sono avvenuti dopo più di 25 mm di pioggia nelle due settimane precedenti (55 mm in media), quindi la maggior parte delle misurazioni è stata effettuata quando l'intero campo era stato bagnato da poco, qualunque fosse il suo livello di irrigazione.

Valutazione generale

  • Azoto: l'NDVI da drone contiene un segnale dell'azoto reale e ripetibile. Il modello individua in modo affidabile le parcelle non concimate, ma non riesce a separare la mezza dose dalla dose piena. Il suo 51% è nettamente sopra il caso (33%) e a circa metà strada dal limite pratico (circa 67%).
  • Irrigazione: i dati non contengono alcun segnale irriguo utilizzabile. I livelli di irrigazione coincidono con la posizione nel campo, e la pioggia ha coperto la maggior parte del fabbisogno idrico in entrambe le stagioni. È un limite del disegno della prova e del meteo, non del modello.
  • Più dati dello stesso tipo o un altro algoritmo difficilmente aiuterebbero: tutti i 12 modelli si comportano allo stesso modo, e ampliare il set di addestramento da 24 a 43 parcelle ha migliorato l'accuratezza sull'azoto di soli 2,7 punti.

Possibili miglioramenti

Esprimere l'NDVI di ogni parcella rispetto alle altre parcelle dello stesso volo ha portato nei test l'accuratezza sull'azoto dal 49% al 56%; non fa parte del modello consegnato. Per le prove future: distribuire i livelli di irrigazione nel campo invece che a fasce, registrare date e quantità di irrigazione, misurare l'umidità del suolo e testare bande spettrali oltre l'NDVI, come il red edge.

Rapporti

  • Data Processing Model Training ReportPDF
  • Input Data Infrastructure and Data Processing Model Selection ReportPDF
  • Data Collection 2 Software Integration ReportPDF