Software I: Datenverarbeitungsmodell

Modell zur Verarbeitung von NDVI-Daten.

Berlin, Germany15. Dezember 2025 – 31. Oktober 2026

Erste Datenerhebung

Die Saison 2025: wie die Eingangsdaten aufbereitet, welches Modell gewählt und wie es trainiert wurde.

Analyse der Eingangsdaten-Infrastruktur

Überblick

Dieser Bericht stellt einen methodischen Rahmen vor, um multispektrale Drohnendaten von Weizenparzellen zu verarbeiten und den Stickstoff- und Wasserbedarf mit maschinellem Lernen und einer LLM-basierten Bewertung abzuschätzen.

Datenaufbereitung und Definition

Der Datensatz verbindet XML-Statistiken aus multispektralen Drohnenbildern mit den Stickstoff- und Bewässerungsvariablen der Parzellen.

  • Stickstoffklassen: 0 g/m² (niedrig), 10 g/m² (mittel), 20 g/m² (ideal).
  • Bewässerungsklassen: 0 % (niedrig), 50 % (mittel), 100 % (ideal).
  • Erste Korrelationsanalyse: Stickstoff hängt stärker mit dem NDVI zusammen als die Bewässerung.

Methodik und Datenverarbeitung

  • Umwandlung der Daten vom breiten Format (Datumsspalten) ins lange Format (eine Zeile je Messzeitpunkt).
  • Hinzufügen von DAS (Tage nach der Aussaat), um den Einfluss des biologischen Alters auf den NDVI-Verlauf abzubilden.
  • Normalisierung der Merkmale mit StandardScaler; Kodierung kategorialer Werte mit LabelEncoder.
  • Hinzufügen der Heterogenitätsspanne (Max–Min) als Merkmal, um die Variabilität innerhalb der Parzelle zu erfassen, die für Wasserstress relevant ist.
Modellauswahl

Maschinelles Lernen und große Sprachmodelle im Vergleich

  • ML: geringer Rechenaufwand, deterministisch zuverlässig, erfordert Fachwissen für die Merkmalsgestaltung (DAS, Skalierung).
  • LLM: hohe Rechen- bzw. API-Kosten, kann logische Zusammenhänge erfassen, birgt aber das Risiko von Halluzinationen.
  • Few-Shot-Aufbau: 215 echte Trainingsbeispiele vorgeben und 55 Testvorhersagen anfordern.

Ergebnisse der Analyse

Stickstoffvorhersage

Kernergebnisse

Gemini 3 (LLM) erreichte 72,73 % Genauigkeit; unter den ML-Modellen lag Naive Bayes mit 65,50 % vorn.

Vorhersage von Wasserstress (Bewässerung)

Kernergebnisse

Gemini 3 und DeepSeek-V3 erreichten 54,55 %; unter den ML-Modellen lag der Entscheidungsbaum mit 49,10 % vorn.

Vollständiger Vergleich

Die eingebettete Ergebnistabelle enthält alle bewerteten Modelle und ihre Genauigkeiten.

Gesamtbewertung und Fahrplan

  • Wichtigste Erkenntnis: Eine fachlich fundierte Verarbeitung (vor allem DAS) ist entscheidend.
  • Entscheidung: Naive Bayes für Stickstoff (kostengünstig und unter den ML-Modellen stabil).
  • Entscheidung: Entscheidungsbaum für Wasserstress, um nichtlineare Verzweigungen zu erfassen.

Modelltraining

Überblick

Dieser Bericht beschreibt Trainingsmethodik, Auswahlkriterien und Betriebsabläufe für Klassifikationsmodelle, die mit aufbereiteten Agrardaten (DAS, Spektralstatistiken, Parzellen-IDs) trainiert wurden.

Trainingsstrategie und Methodik

  • Gruppenbasierte Aufteilung (GroupShuffleSplit): Gruppierung nach Parzellen-ID, damit das Modell dieselbe Parzelle zu verschiedenen Terminen nicht auswendig lernt.
  • Bei der Wahl des Algorithmus zählen Eignung für wenige Daten und agronomische Logik mehr als reine mathematische Genauigkeit.
  • Standardisierung und Kodierung: Eingaben mit StandardScaler normalisieren, Zielwerte per Label Encoding kodieren.

Kerngedanke

Die Generalisierung wird auf Parzellen geprüft, die das Modell nie gesehen hat, indem keine Parzellen-ID zugleich in Trainings- und Testdaten vorkommt.

Gewählte Modelle und Begründung

Stickstoffvorhersage

Gaussian Naive Bayes – 65,5 % Genauigkeit

Gewählt wegen seiner Stabilität bei wenigen Beobachtungen und der starken Korrelation zwischen NDVI bzw. Spektralindizes und Stickstoff; das verringert das Risiko der Überanpassung.

Bewässerungsvorhersage

Entscheidungsbaum – 49,1 % Genauigkeit

Gewählt, um nichtlineare, schwellenwertgetriebene Effekte der Bewässerung auf die Pflanzenmorphologie zu erfassen.

Modellverwaltung

  • Persistenz: Trainierte Modelle, Skalierer und Label-Encoder werden als .pkl gespeichert und ohne erneutes Training wiederverwendet.
  • Inferenz-Pipeline: nimmt rohe XML-Daten und Flugdaten entgegen und wendet dieselben Skalierungs- und Kodierungsschritte an wie im Training.

Gesamtbewertung und Einschränkungen

Der wichtigste Engpass ist der geringe Umfang des Datensatzes; die Bewässerungsgenauigkeit ist durch zu wenig Vielfalt für eine Generalisierung begrenzt.

Fazit

Die Infrastruktur ist logisch validiert; mit wachsender Datenmenge wird durch erneutes Training eine höhere Genauigkeit erwartet, ohne strukturelle Codeänderungen.

Zweite Datenerhebung

Modellaktualisierung und Genauigkeitsanalyse nach der zweiten Datenerhebung

Die zweite Datenerhebung

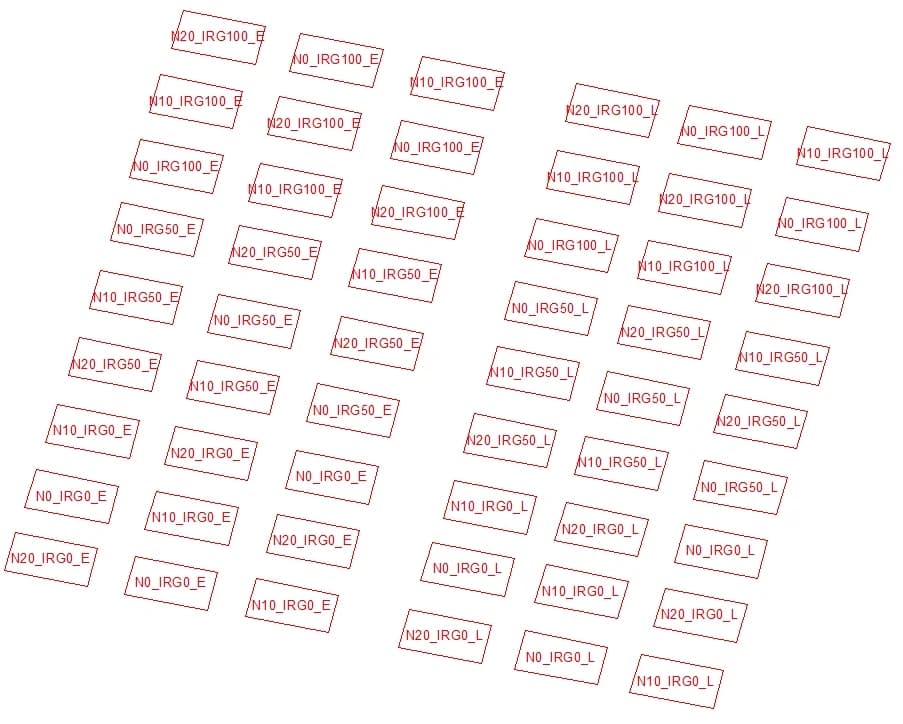
Die zweite Datenerhebung umfasst die Weizensaison 2026 auf demselben Versuchsfeld mit 54 Parzellen in Adana, betrieben von der Universität Çukurova. Der Versuchsaufbau entspricht der ersten Saison: drei Stickstoffstufen (0, 10 und 20 g/m²) und drei Bewässerungsstufen (0 %, 50 % und 100 %), jede der neun Kombinationen auf sechs Parzellen, in zwei Aussaatblöcken (frühe Aussaat am 26. Dezember 2025, späte Aussaat am 9. März 2026).

Zwischen dem 24. Februar und dem 30. Juni 2026 wurde das Feld siebenmal mit einer Multispektraldrohne DJI Mavic 3M in 50 m Höhe beflogen. Die Bilder wurden zu NDVI-Karten verarbeitet und als zonale Statistiken je Parzelle geliefert, eine Tabelle pro Flug.

Karte der 54 Parzellen, jede mit ihrer Variante beschriftet, zum Beispiel N20_IRG100_E: 20 g/m² Stickstoff, 100 % Bewässerung, frühe Aussaat.
Der Versuchsaufbau aus dem Datenarchiv der Universität Çukurova: jede Parzelle mit Stickstoffstufe (N0, N10, N20), Bewässerungsstufe (IRG0, IRG50, IRG100) und Block (E früh, L spät) beschriftet. Die Bewässerung verläuft in Bändern quer durch jeden Block; der Stickstoff variiert innerhalb jedes Bandes.
  • Saison 2025: 5 Flüge (15. April – 16. Juni 2025), 270 Parzellenmessungen.
  • Saison 2026: 7 Flüge (24. Februar – 30. Juni 2026), 324 Parzellenmessungen.
  • Insgesamt: 594 Parzellenmessungen von 54 Parzellen über zwei Saisons.

Vorgehen

Die beiden Saisons wurden als ein einheitlicher Datensatz aufbereitet, für Stickstoff und für Bewässerung wurde jeweils das beste Modell ausgewählt und das Ergebnis analysiert. Alle Schritte sind reproduzierbare Python-Notebooks; jede Zahl ist aus den Daten berechnet.

  • Gleiche Messmethode für beide Saisons: Es wurden nur Statistiken verwendet, die in beiden Jahren vorliegen (Mittelwert, Maximum, Minimum, Standardabweichung und Spannweite des NDVI je Parzelle sowie die Tage nach der Aussaat).
  • Prüfung der Beschriftung: Bei 10 Parzellen des späten Blocks widersprach die Beschriftungstabelle 2026 dem Parzellencode; verwendet wurde der Parzellencode, da er mit dem Versuchsaufbau 2025 und der Feldkarte übereinstimmt.
  • Ungültige Messungen entfernt: Zwei Flüge 2026 fanden vor der Aussaat des späten Blocks statt; diese 54 Messungen zeigten daher kahlen Boden, keinen Weizen.
  • Gleiche Nutzung wie im Feld: Das Modell sagt die Stufen einer Parzelle aus einem einzelnen Flug und den Tagen nach der Aussaat voraus, genau wie die Software es nutzt.
  • Faire Tests: Alle Messungen einer Parzelle bleiben zusammen im Training oder im Test; 5 Parzellengruppen, dreimal wiederholt, ergeben 15 Testrunden. Zufälliges Raten erreicht 33 %.

Getestete und ausgewählte Modelle

Getestet wurden zwölf Klassifikationsmodelle aus allen gängigen Familien: Logistische Regression, Ridge, k-nächste Nachbarn, Naive Bayes, Support Vector Machine, Entscheidungsbaum, Random Forest, Extra Trees, AdaBoost, Gradient Boosting, XGBoost und CatBoost. Alle lagen in einem engen Bereich: 42–51 % für Stickstoff und 27–36 % für Bewässerung. Der Abstand zwischen bestem und schlechtestem Modell (etwa 9 Punkte) entspricht der normalen Schwankung zwischen den Testrunden (etwa ±6 Punkte); die Wahl des Algorithmus hat also wenig Einfluss.

Stickstoff: XGBoost

51 % Genauigkeit · Zufall 33 % · p = 0,01

Erkennt Parzellen ohne Düngung zuverlässig, verwechselt aber oft die Stufen 10 und 20 g/m². Ein Permutationstest bestätigt, dass das Stickstoffsignal echt ist.

Bewässerung: Extra Trees

36 % Genauigkeit · p = 0,14

Der höchste Wert unter den Kandidaten, aber statistisch nicht vom Zufall zu unterscheiden. Er ist der Vollständigkeit halber in der Software; seine Ausgabe sollte nicht für Bewässerungsentscheidungen genutzt werden.

Warum sich die Modelle gegenüber Datenerhebung 1 geändert haben

Die erste Phase wählte Naive Bayes (Stickstoff) und einen Entscheidungsbaum (Bewässerung) anhand einer einzigen Testaufteilung mit 11 Parzellen. Über 15 Runden gemessen erreichte Naive Bayes 42 % für Stickstoff und gehört damit zu den schwächsten der 12 Modelle. Außerdem nutzten die Modelle der ersten Phase den NDVI-Median, der in den Tabellen 2026 fehlt; eine neue Auswahl war also ohnehin nötig.

Warum die Genauigkeit nicht gestiegen ist

Der erste Bericht nannte 65,5 % für Stickstoff und 49,1 % für Bewässerung, aus einer einzigen Testaufteilung. Wiederholt über 200 zufällige Aufteilungen ergab dasselbe Verfahren im Mittel 44 % für Stickstoff, und die unveränderten Modelle der ersten Phase erreichten auf den Daten 2026 47 % und 36 %. Die neuen Zahlen sind kein Rückschritt, sondern eine verlässlichere Messung derselben Grenze – und die liegt darin, was der NDVI in diesem Versuch zeigen kann.

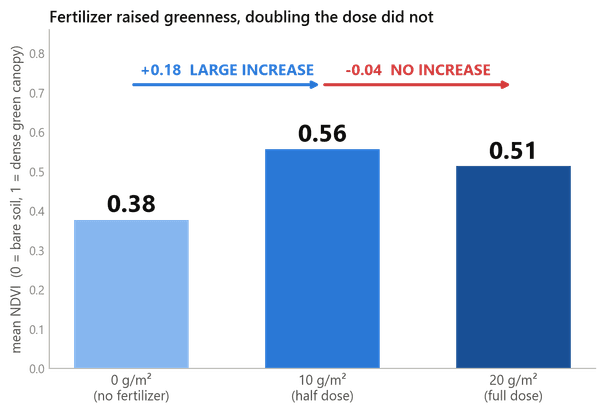
Balkendiagramm: mittlerer NDVI 0,38 bei 0 g/m², 0,56 bei 10 g/m², 0,51 bei 20 g/m² Stickstoff.
Abbildung 1. Mittlerer NDVI nach Stickstoffstufe (alle 594 Messungen, beide Saisons).

Die halbe Dosis hob den NDVI deutlich (von 0,38 auf 0,56); die volle Dosis hob ihn nicht weiter (0,51). Ungedüngte Parzellen lassen sich unterscheiden (80 % in einem Zwei-Klassen-Test gegenüber 67 %, wenn man immer „gedüngt“ rät), halbe und volle Dosis dagegen nicht (49 %, ein Münzwurf). Die praktische Obergrenze für Stickstoff liegt daher bei etwa 67 %, und das gewählte Modell legt etwa die Hälfte des Weges vom Zufall bis zu dieser Grenze zurück.

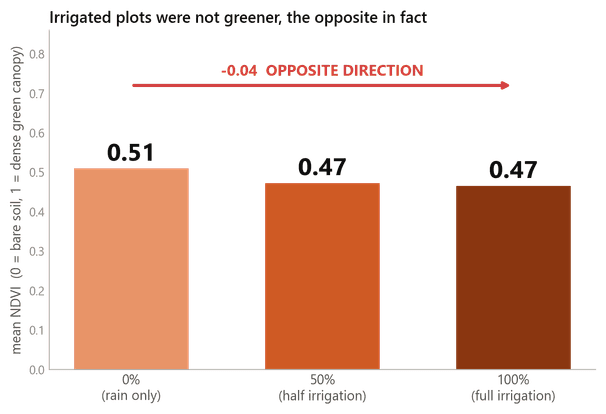
Balkendiagramm: Der mittlere NDVI ist bei 0 %, 50 % und 100 % Bewässerung nahezu gleich.
Abbildung 2. Mittlerer NDVI nach Bewässerungsstufe (alle 594 Messungen, beide Saisons).

Die drei Bewässerungsstufen haben nahezu denselben mittleren NDVI, und unbewässerte Parzellen waren sogar etwas grüner (0,51) als voll bewässerte (0,47). Jede Bewässerungsstufe nimmt einen durchgehenden Streifen des Feldes ein, sodass Bewässerungsstufe und Lage im Feld dieselbe Variable sind (Spearman ρ = 0,94; für Stickstoff ρ = 0,01): Kein Modell kann Wasser von Lage unterscheiden.

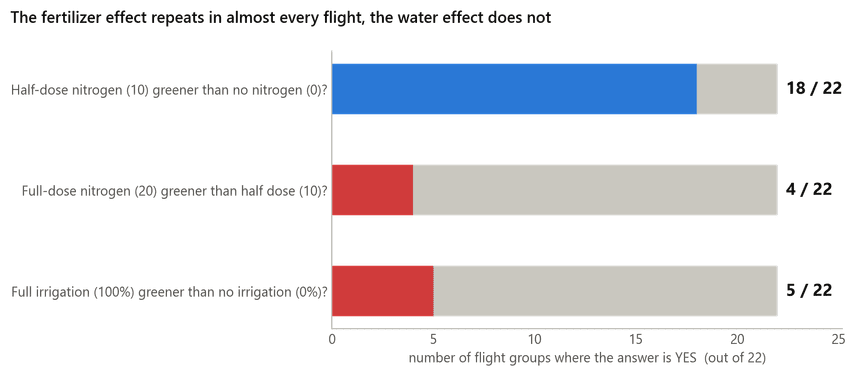
Diagramm: in wie vielen von 22 Fluggruppen jeder NDVI-Vergleich zutrifft.
Abbildung 3. Anzahl der Fluggruppen, in denen jeder Vergleich zutrifft (12 Flüge × 2 Aussaatblöcke = 22 Gruppen).

Flug für Flug geprüft, war die halbe Dosis in 18 von 22 Gruppen grüner als keine Düngung; der Stickstoffeffekt ist also beständig. Die volle Dosis war nur in 4 von 22 Gruppen grüner als die halbe, und voll bewässerte Parzellen waren nur in 5 von 22 grüner als unbewässerte.

Wetter: Hatte es schon genug geregnet?

Das tägliche Wetter am Feld (ERA5-Reanalyse, Open-Meteo-Archiv) wurde mit dem Wasserbedarf der Kultur verglichen (Referenzverdunstung, ET₀). Bewässerungstermine und -mengen lagen nicht vor; die Analyse stützt sich daher nur auf Wetterdaten.

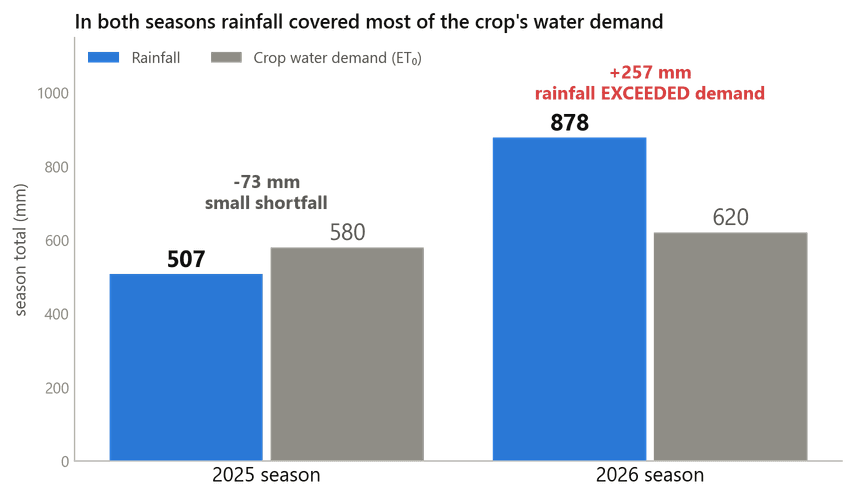
Balkendiagramm: Niederschlag 2025 507 mm bei 580 mm Bedarf; 2026 878 mm bei 620 mm Bedarf.
Abbildung 4. Gesamtniederschlag und Wasserbedarf der Kultur (ET₀) von der frühen Aussaat bis zum letzten Flug jeder Saison.
  • 2025: 507 mm Regen bei einem Bedarf von 580 mm; der Regen deckte etwa 87 % des Bedarfs.
  • 2026: 878 mm Regen bei 620 mm Bedarf; der Regen überstieg den Bedarf um 257 mm, sodass selbst nie bewässerte Parzellen mehr Wasser erhielten als nötig.
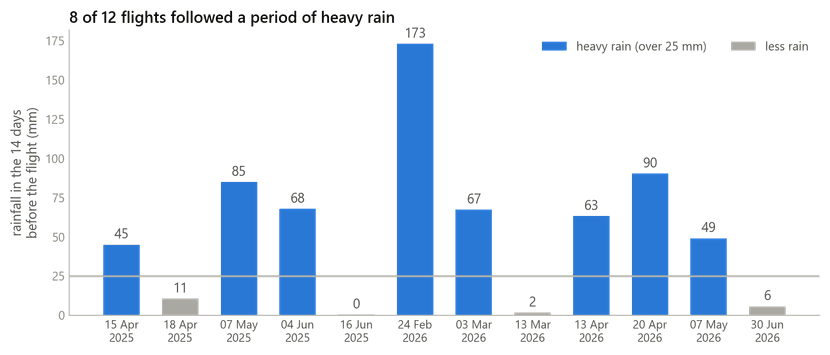
Diagramm: Niederschlag in den 14 Tagen vor jedem der 12 Drohnenflüge.
Abbildung 5. Niederschlag in den 14 Tagen vor jedem Drohnenflug.

8 der 12 Flüge folgten auf mehr als 25 mm Regen in den zwei Wochen davor (im Mittel 55 mm); die meisten Messungen entstanden also, als das ganze Feld kurz zuvor durchfeuchtet worden war, unabhängig von der Bewässerungsstufe.

Gesamtbewertung

  • Stickstoff: Der Drohnen-NDVI enthält ein echtes, wiederholbares Stickstoffsignal. Das Modell erkennt ungedüngte Parzellen zuverlässig, kann aber halbe und volle Dosis nicht trennen. Seine 51 % liegen deutlich über dem Zufall (33 %) und etwa auf halbem Weg zur praktischen Obergrenze (etwa 67 %).
  • Bewässerung: Die Daten enthalten kein brauchbares Bewässerungssignal. Die Bewässerungsstufen fallen mit der Lage im Feld zusammen, und in beiden Saisons deckte Regen den größten Teil des Wasserbedarfs. Das ist eine Grenze des Versuchsaufbaus und des Wetters, nicht des Modells.
  • Mehr Daten derselben Art oder ein anderer Algorithmus helfen kaum: Alle 12 Modelle schneiden ähnlich ab, und die Vergrößerung des Trainingssatzes von 24 auf 43 Parzellen verbesserte die Stickstoffgenauigkeit nur um 2,7 Punkte.

Mögliche Verbesserungen

Wird der NDVI jeder Parzelle relativ zu den anderen Parzellen desselben Flugs ausgedrückt, steigt die Stickstoffgenauigkeit in Tests von 49 % auf 56 %; im gelieferten Modell ist das noch nicht enthalten. Für künftige Versuche: Bewässerungsstufen über das Feld verteilen statt in Streifen, Bewässerungstermine und -mengen dokumentieren, Bodenfeuchte messen und Spektralbänder über NDVI hinaus testen, etwa Red Edge.